用 4000 张图训一个牙科照片分类器:从 VL 大模型试错到 ResNet-18 落地
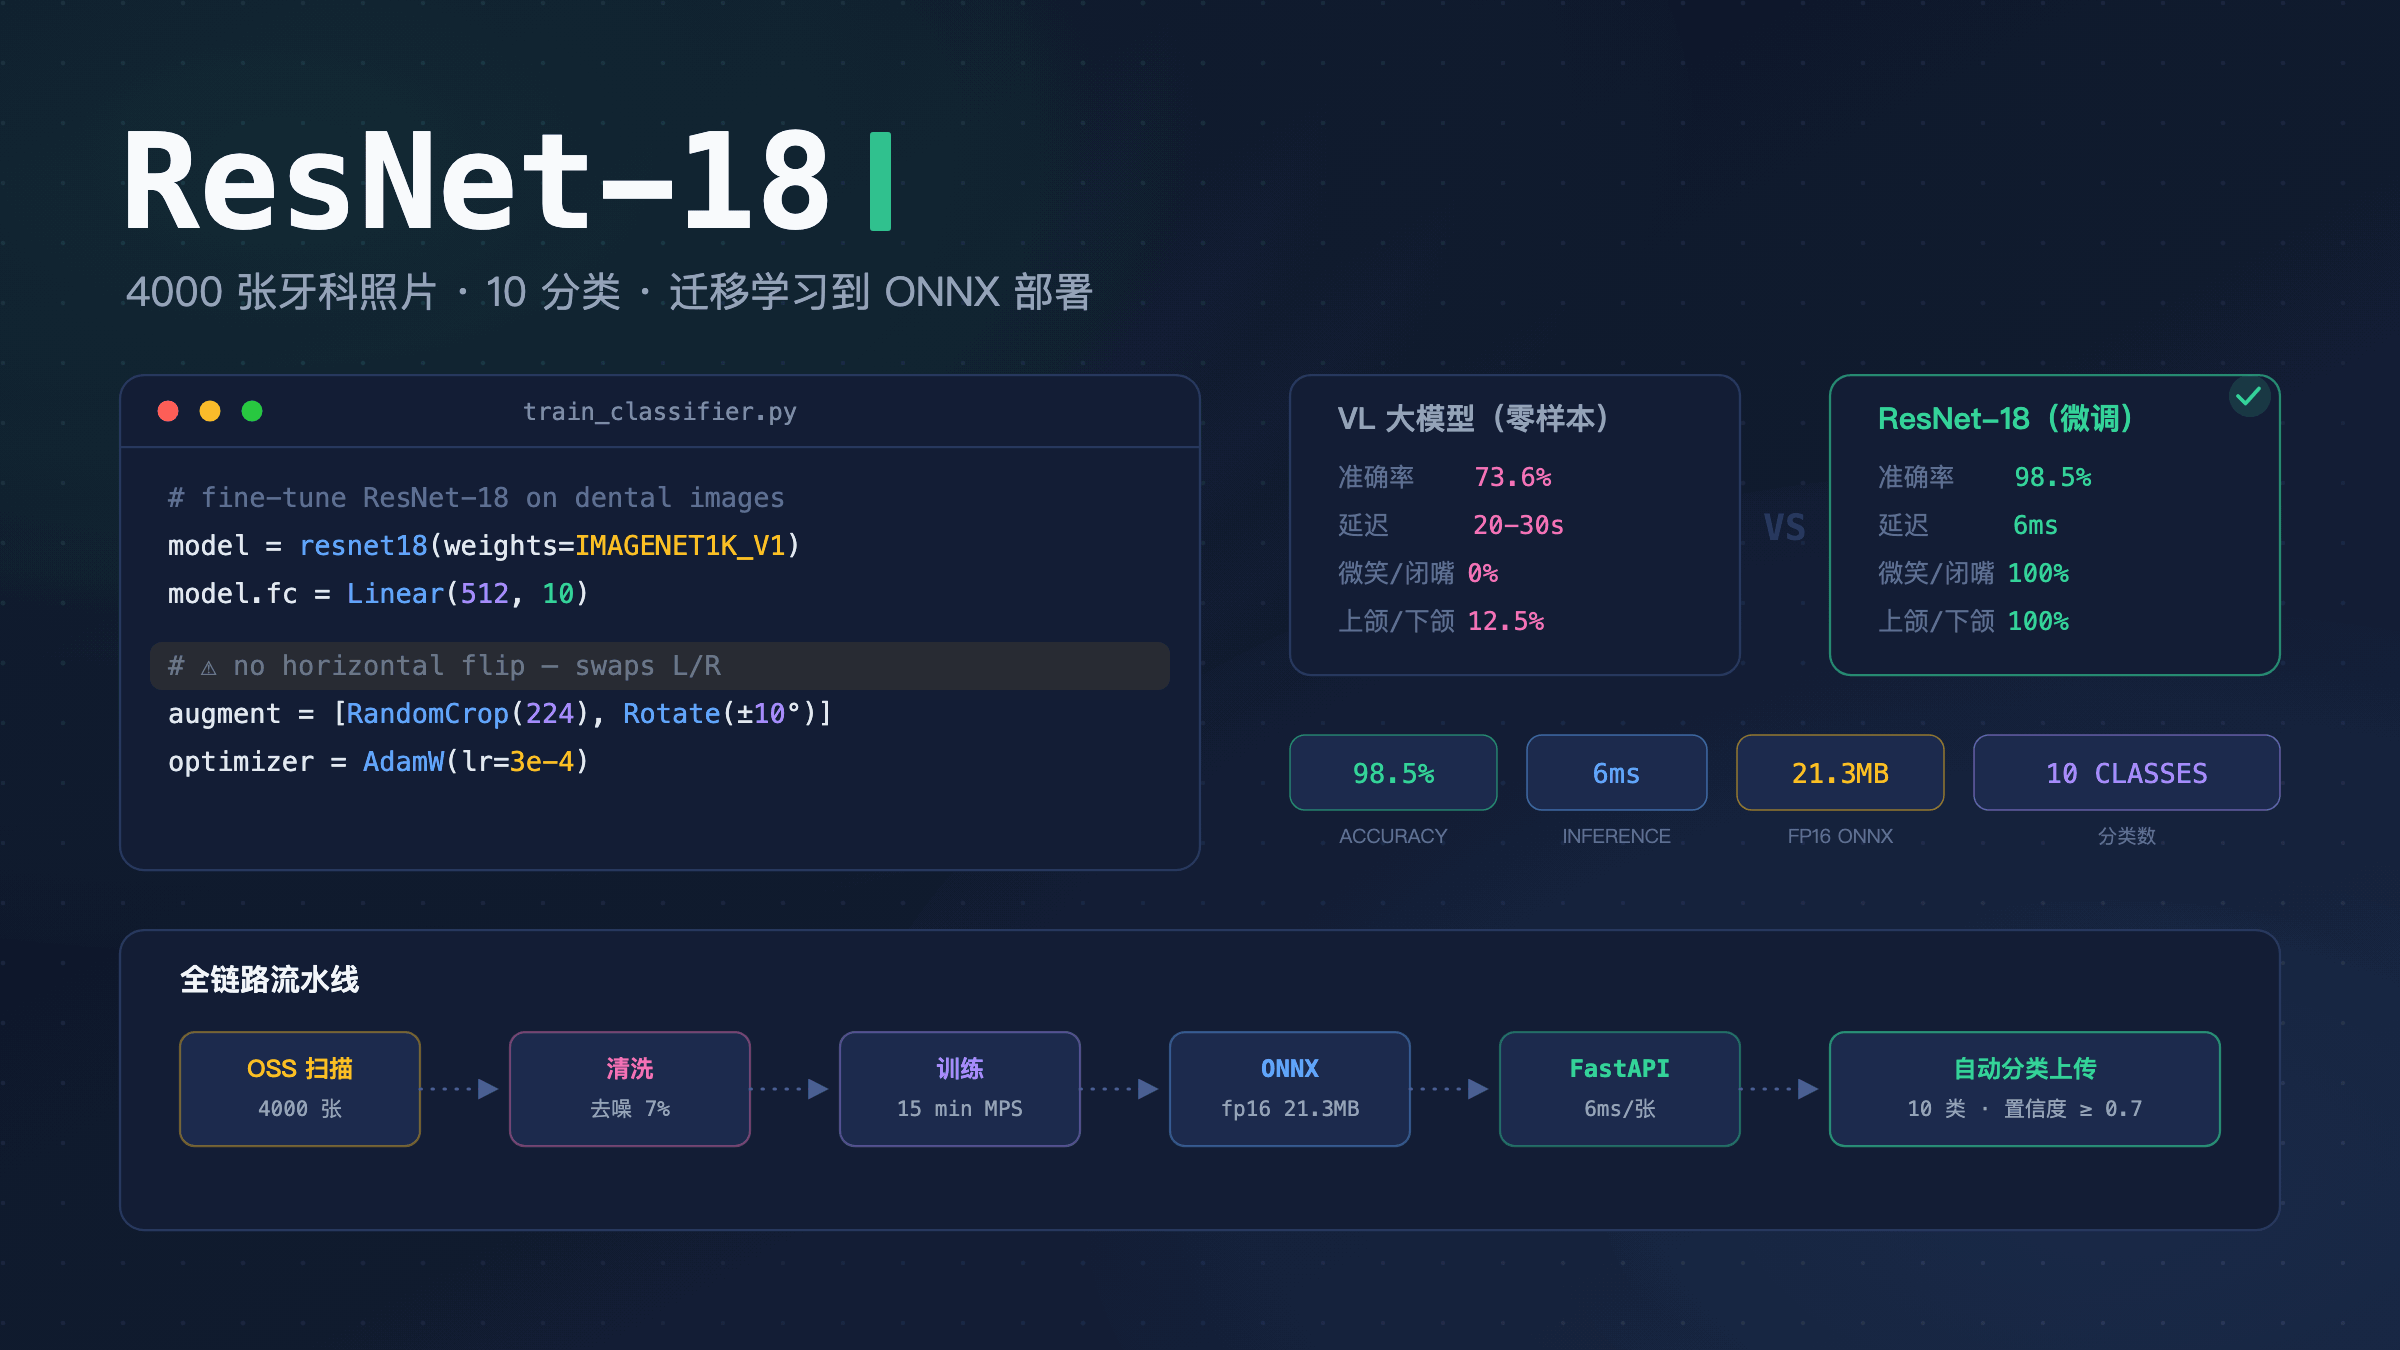
做口腔诊断系统时遇到一个体验痛点:医生提交病例需要上传 10 类照片(X 光片、面部照片、口腔内照片),每次都要手动逐张选择分类、逐张上传。能不能一次拖入所有照片,系统自动识别分类?
这篇文章记录我从零开始的完整过程:先试 VL 大模型零样本分类碰壁,再用迁移学习训练专用小模型,最终部署上线的全链路实践。
问题定义
10 个分类,涵盖三个大类:
| 大类 | 分类 | 特征 |
|---|---|---|
| X 光片 | 侧位片 (ceph)、全景片 (composite) | 灰度医学影像 |
| 面部照片 | 侧面、正面、正面微笑 | 彩色人像照片 |
| 口腔内照片 | 上颌、下颌、右侧、正面、左侧 | 口腔特写,通常有开口器 |
直觉上差异很大——X 光片和彩色照片一眼就能区分。但细看有几对”混淆组”:
- 侧位片 vs 全景片(都是灰度 X 光)
- 正面 vs 正面微笑(差别只在嘴巴闭合/露齿)
- 上颌 vs 下颌(咬合面照片结构相似)
- 口内左侧 vs 右侧(镜像对称)
第一次尝试:VL 大模型零样本分类
最直觉的方案是调一个视觉语言模型(Vision-Language Model),用 prompt 告诉它分类规则,让它看图返回类别。
我用了阿里云百炼平台上的 qwen3.8-max(支持图片输入),写了一段详细的分类 prompt,包含每个类别的视觉特征描述。用 8 个患者、80 张图做了测试。
结果:73.6%,不可用
| 分类 | 准确率 | 问题 |
|---|---|---|
| 面部侧面/正面/口腔左右正 | 100% | 跨大类无压力 |
| 正面微笑 | 0% | 全部判成正面(闭嘴) |
| 下颌 | 12.5% | 几乎全判成上颌 |
| 侧位片 | 62.5% | 部分误判为全景片 |
关键发现:
- 细粒度区分是 VL 模型的盲区——它理解”这是一张口腔照片”,但分不清上颌和下颌的牙弓形态差异
- 单张延迟 20-200 秒——图片越大越慢,即使压缩到 1024px 仍需 20-30s,10 张图要等 3-5 分钟
- 每张图几分钱的 API 费用——量少时可忽略,但作为生产功能不理想
VL 模型擅长开放域理解,但在封闭域精细分类上,它不如一个小模型”看过”几千张同场景数据后的判别力。
第二次尝试:训练专用小模型
数据来了免费的
关键洞察:系统的历史数据本身就是标注好的训练集。
文件存储在云端对象存储里,路径约定是 {分类}_{序号}_{时间戳}.jpg——这就是医生在上传时手动选的分类标签。我写了一个脚本扫描存储桶,按路径提取标签,下载并归一化(EXIF 方向修正、长边缩到 640px、统一 JPEG),得到了 500 个患者、约 5000 张图的数据集。
按患者切分,而非按图片
这是一个容易忽略但很关键的点:同一个患者的 10 张照片是同一相机、同一背景、同一光线拍的。如果随机按图片切分训练/测试集,同一患者的照片可能同时出现在两边,模型学的是”认出某个患者”而非”识别照片类型”,导致测试准确率虚高。
正确做法:用患者 ID 的哈希值决定 train/val/test 归属(80/10/10),保证同一患者的所有照片只在一个集里。这样测试集里全是模型从没见过的患者,数字可信。
模型选择:ResNet-18 + ImageNet 预训练
10 个分类、4000 张训练图——不需要 ViT 也不需要 ResNet-50。ResNet-18 有 11.7M 参数,ImageNet 预训练后微调,在这个数据量级上就是甜点。
关键决策记录:
1
2
3
# 骨干:ResNet-18,替换最后的全连接层
model = models.resnet18(weights=ResNet18_Weights.IMAGENET1K_V1)
model.fc = nn.Linear(model.fc.in_features, 10)  # 10 分类
数据增强:有一个不能做的事
常规增强:随机裁剪缩放、轻微旋转(±10°)、颜色抖动——这些模拟了不同拍摄条件。
但不能做水平翻转。原因:翻转会把”口内右侧照”变成”口内左侧照”的样子,标签却没变——等于在教模型犯错。这是领域特异的约束,容易被忽略。
1
2
3
4
5
6
7
8
TRAIN_TRANSFORM = transforms.Compose([
    transforms.RandomResizedCrop(224, scale=(0.8, 1.0)),
    transforms.RandomRotation(10),
    transforms.ColorJitter(brightness=0.2, contrast=0.2, saturation=0.2, hue=0.05),
    # ⚠️ 不做水平翻转 — 会交换 left/right 语义
    transforms.ToTensor(),
    transforms.Normalize(IMAGENET_MEAN, IMAGENET_STD),
])
训练配置
| 参数 | 值 | 理由 |
|---|---|---|
| 优化器 | AdamW, lr=3e-4 | 自适应学习率,对微调友好 |
| 权重衰减 | 1e-4 | L2 正则,抑制过拟合 |
| 学习率调度 | CosineAnnealingLR | 后期精细收敛 |
| Batch size | 128 | M-chip Mac 上 MPS 后端跑得动 |
| Epochs | 15 | best-checkpoint 机制兜底过拟合 |
全程在 MacBook Pro(Apple Silicon)上用 MPS 后端训练,每个 epoch 约 60 秒,总共不到 15 分钟。
冒烟测试的惊喜
第一次拿 840 张训练图跑 3 个 epoch(还没下完整数据集),val 就到了 94.1%——VL 大模型 0% 的正面微笑分类,小模型直接 100%。这证实了方向正确。
数据清洗:最耗时但最值得
训练完用模型反扫全量数据时发现了一个意外的问题:约 7% 的历史标签是错的。
错误模式:
- 医生把全景片上传到了侧位片的槽位(可能界面上挨着,手滑)
- 同一张图被传到了两个不同槽位(重复上传)
- 手机拍的屏幕截图当成了 X 光原片上传
- 下颌照片上传到了上颌的位置
这些”脏标签”会系统性地压低测试准确率——模型判对了,但因为标签本身是错的,被算成了”分类错误”。
清洗流程
- 模型反扫:用当前模型对全量数据推理,找出”预测 ≠ 标签”的嫌疑清单(约 340 张)
- 文件哈希去重:自动找出同图跨槽位的副本(发现 221 对),保留模型预测类别的那份,删另一份
- 人工复核嫌疑清单:逐张看图确认,错的删掉
- 二次扫描:清洗后重训模型,再扫一轮——更强的模型能发现上一轮漏掉的噪声
两轮清洗后,训练集从 4298 张降到 ~4000 张(净减 ~7%),但质量大幅提升。
清洗前后对比
| 指标 | 清洗前 | 清洗后 |
|---|---|---|
| val 准确率 | 91.6% | 98.5% |
| test 准确率 | 90.2% | 94.3% |
| ceph recall | 73% | 100% |
| composite recall | 90% | 98% |
test 和 val 的差距(98.5 vs 94.3)说明 test 里仍有少量漏网的脏标签在拖后腿——模型本身的真实能力已经接近 98%。
教训:数据质量 > 数据数量 > 模型复杂度。 花 1 小时清洗比花 1 天调模型结构有效得多。
部署:ONNX + 量化
为什么导出 ONNX
PyTorch 模型直接部署需要完整的 Python + torch 运行时(几百 MB)。导出为 ONNX 后:
- 推理只依赖 ONNX Runtime(几十 MB),不需要 torch
- 跨语言:Python、C++、JavaScript(浏览器)都能跑
- 推理优化:ORT 自动做算子融合、内存复用等
1
2
3
4
torch.onnx.export(model, dummy_input, "classifier.onnx",
                  input_names=['image'], output_names=['logits'],
                  dynamic_axes={'image': {0: 'batch'}},
                  opset_version=17, dynamo=False)
注意 dynamo=False:PyTorch 2.x 默认使用新的 dynamo exporter,它会把权重拆到一个 .onnx.data 文件里。加这个参数可以得到一个自包含的单文件,部署时不怕漏拷。
量化:体积 vs 精度的权衡
| 变体 | 体积 | 准确率 | 延迟/张 |
|---|---|---|---|
| fp32 (原始) | 42.6 MB | 94.3% | 5.8ms |
| fp16 | 21.3 MB | 94.3% | 5.7ms |
| int8 dynamic | 10.7 MB | 93.3% | 5.5ms |
| int8 static (含校准) | 10.7 MB | 93.3% | 1.7ms |
fp16 是免费午餐:体积减半,精度和延迟完全不变。原因是 ResNet-18 的权重动态范围完全在 fp16 能表达的范围内,转换不引入任何舍入误差。
int8 再砍半到 10.7MB,但丢了 1pt。对于将来浏览器端部署(用户需要下载模型),10.7MB 比 21.3MB 又小一倍,1pt 的精度差异可以接受。
一个容易被误导的认知:体积缩小 ≠ CPU 推理变快。fp16 模型在 CPU 上推理时,ORT 会把权重反量化回 fp32 再算——省的是加载时间和内存占用,不是计算时间。int8 确实快(1.7ms vs 5.8ms),因为 int8 乘加有专用指令。但当推理本身只占请求总耗时的 5%(其余是网络 IO)时,这个加速用户无感。
服务集成
分类器作为一个 ONNX session 加载到现有的 Python FastAPI 服务中(与人脸打码模型共存),新增一个 /classify 端点。预处理必须和训练时完全一致:
1
EXIF 方向修正 → 短边缩到 256px → 中心裁剪 224×224 → ImageNet 均值方差归一化 → NCHW
任何一步不一致(比如漏了 EXIF 修正),都会导致线上推理结果和训练时不同——我在调试时就踩过这个坑:一张有 EXIF rotation tag 8 的照片,不做方向修正的话旋转了 90°,模型直接把 frontal_smile 判成了 frontal。
前端交互
最终实现的用户流程:
- 拖入或多选多张照片
- 前端生成缩略图(canvas 压到 640px),base64 送后端分类
- 置信度 ≥ 0.7 且目标槽位为空 → 自动填入对应卡片
- 置信度低或槽位已占 → 进入”待确认”托盘,用户拖放或点选放置
- 直接拖文件到某个卡片 = 跳过分类上传(保留手动习惯)
把分类和上传做成并行:分类请求和 presigned URL 上传同时发起,用户看到的延迟约等于网络往返(~500ms),而非之前逐张手选的重复操作。
复盘与思考
VL 大模型不是银弹
“万能模型+好 prompt” 的思路在开放域任务上很强,但在封闭域精细分类上,一个只有 11M 参数但”见过”你数据的小模型,能以 100-500 倍的速度、更高的准确率碾压它。在已有领域数据时,训练专用模型几乎总是更好的选择。
你的历史数据是金矿
很多系统里已经积累了大量”人工标注过”的数据,只是标注行为发生在业务流程里(用户选了一个分类再上传),不像传统 ML 项目那样有独立的标注环节。识别这些”隐性标注”并加以利用,是很多业务系统引入 ML 的捷径。
数据清洗的 ROI 最高
整个项目最大的准确率跳跃不是来自模型调参或更大的骨干网络,而是来自清洗掉 7% 的脏标签(val 91.6% → 98.5%)。”用模型反扫数据找脏标签”是一个实用的 pattern:
- 先在脏数据上训一版
- 用这版模型预测全量数据
- “预测 ≠ 标签” 的样本大概率是标签错了(模型在大量正确样本里学到了真实 pattern)
- 人工复核清单、清洗、重训
这个循环可以迭代多次,每次模型更强、找到的残余噪声更多。
预处理一致性是隐形杀手
训练和推理的预处理必须逐步骤对齐。我遇到的坑:
- EXIF 方向:手机拍的照片可能带 rotation tag,不处理就是旋转后的像素
- 缩放算法:PIL 的
LANCZOS和 OpenCV 的INTER_AREA在边缘处理上有微小差异 - 色彩空间:有的图是 RGBA 或灰度,必须统一转 RGB
建议:把预处理封装成一个函数,训练和服务端共享同一份代码。
最终数字
| 指标 | 值 |
|---|---|
| 模型 | ResNet-18 fp16 |
| 体积 | 21.3 MB |
| 训练数据 | ~4000 张(清洗后) |
| 训练时间 | 15 分钟(Apple Silicon MPS) |
| val 准确率 | 98.5% |
| test 准确率 | 94.3%(含残余脏标签;干净子集 ~98%) |
| 推理延迟 | 6ms/张(CPU ONNX Runtime) |
| VL 大模型对照 | 73.6%,20-30s/张 |
从”能不能做”到”上线可用”,大约两天的工作量(含数据下载、两轮清洗、VL 实验、训练、部署、前端集成)。瓶颈不是算力也不是模型,而是数据清洗的人工复核时间。